脱敏声明 — 本项目是替服务对象做的内部系统,以脱敏形式展示: 不出现客户名称、账号信息与可反查的内部细节。数字为该版本在验证环境下的实测结果。
问题
美术团队上 AI 出图,卡住的通常不是「模型不够好」,而是三件跟模型无关的事:
一、能力和产出都沉不下来。 每个人各自申请密钥、各自装环境,跑出来的图散在各人机器上; 换个人接手,同样的需求要重新摸一遍。
二、出图靠手感,复现不了。 参数(模型、步数、尺寸、提示词)记在脑子里, 同一个人隔一周也复现不出上一张的构图。
三、想尝鲜,但账单没人管。 聚合平台按张计费,谁在用、用了多少、花在哪一档,没有一处能看全。
做法
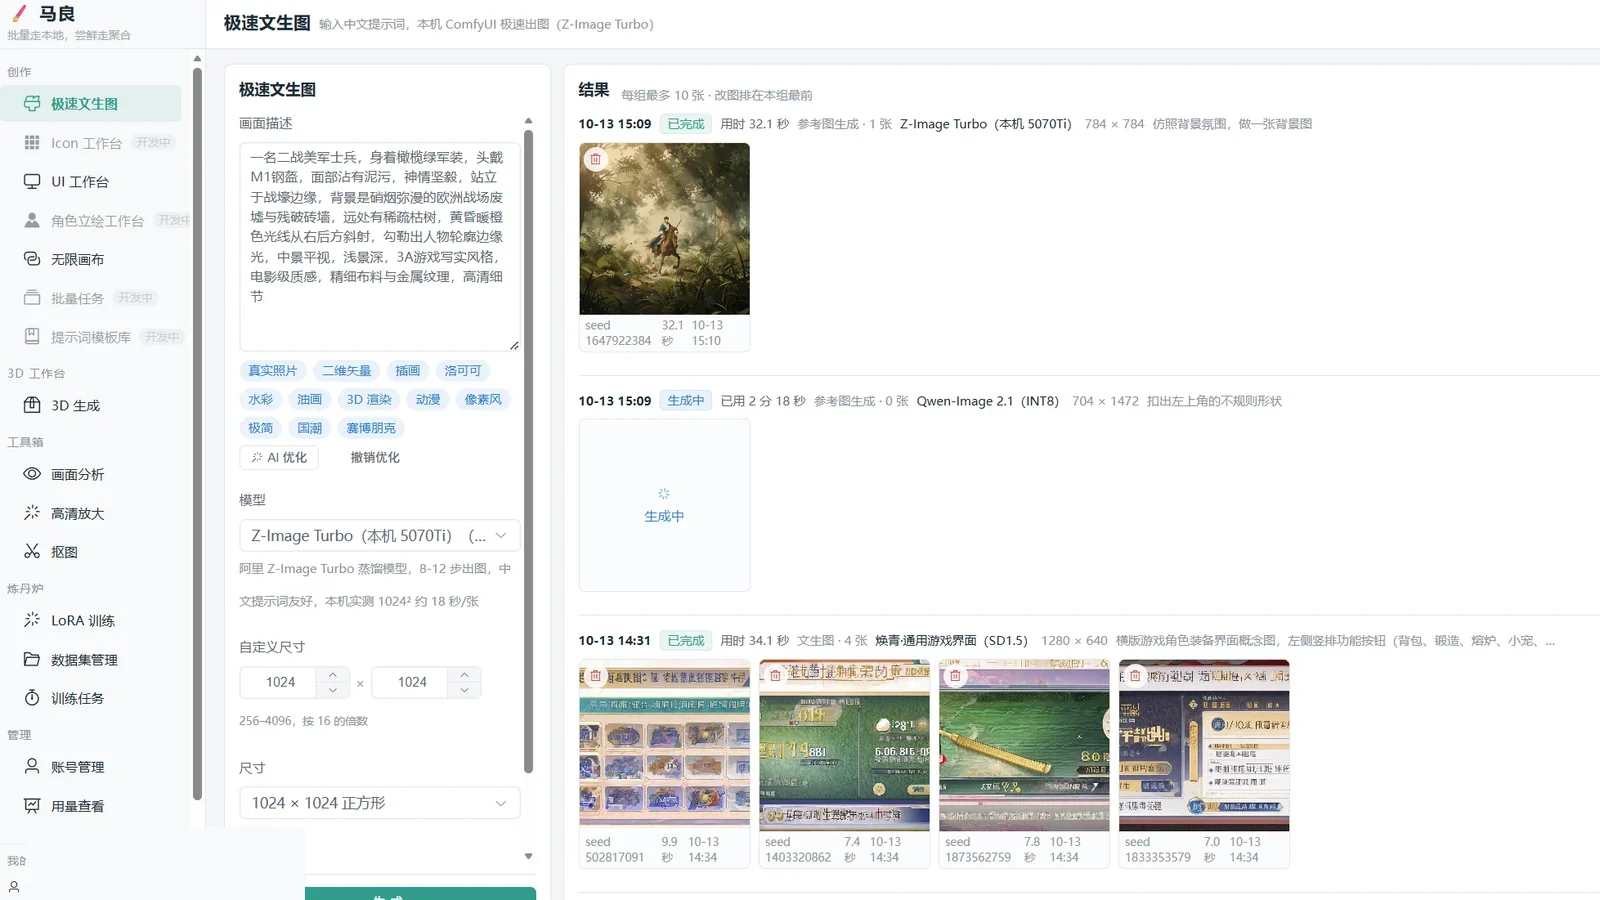
一、先跑通一条链路,再谈平台。 先把「本地文生图」这一条跑通 —— 模型、采样步数、尺寸、队列, 确认单张耗时与显存占用之后,再往上加账号、配额、产物归档。顺序反了就会得到一个壳子。
二、双轨算力:批量走本地,尝鲜走聚合。 日常批量出图走本地显卡,不产生按张账单; 要试新模型时走聚合通道,代价是按张计费 —— 所以页面上直接给出成本预估, 并把最高档(4K)锁掉,避免「顺手点一下」变成账单。
三、把提示词优化并进流程里。 「画面描述 → AI 优化 → 出图」是一串动作, 优化那一步单独计时(1.2 秒),出图 17.3 秒 —— 端到端可预期,美术同学才知道点完要等多久。
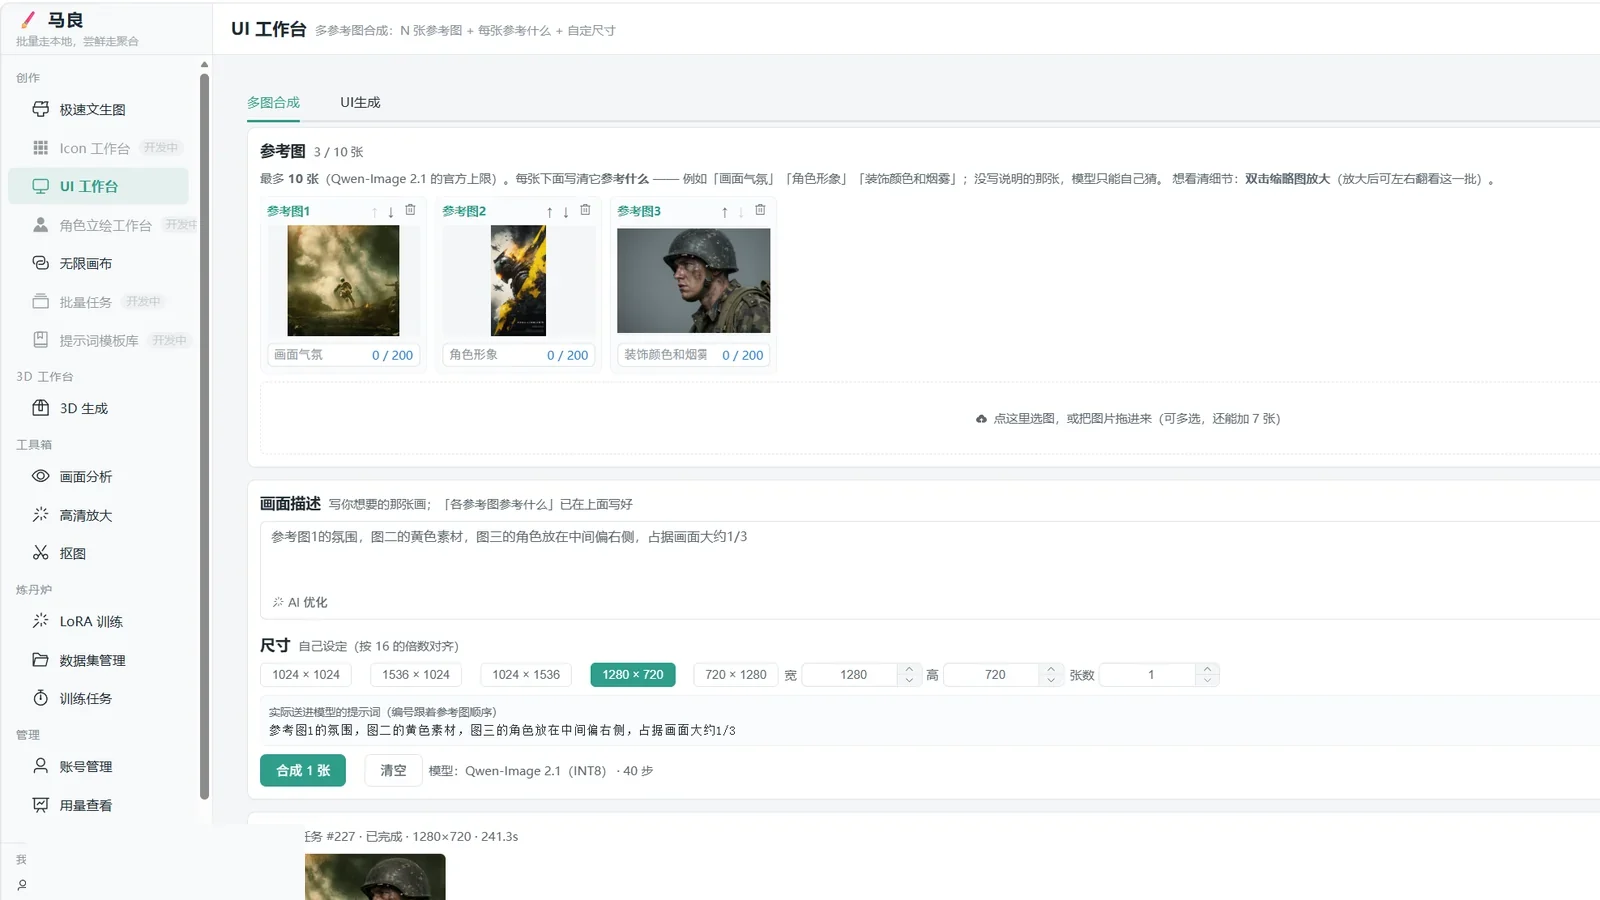
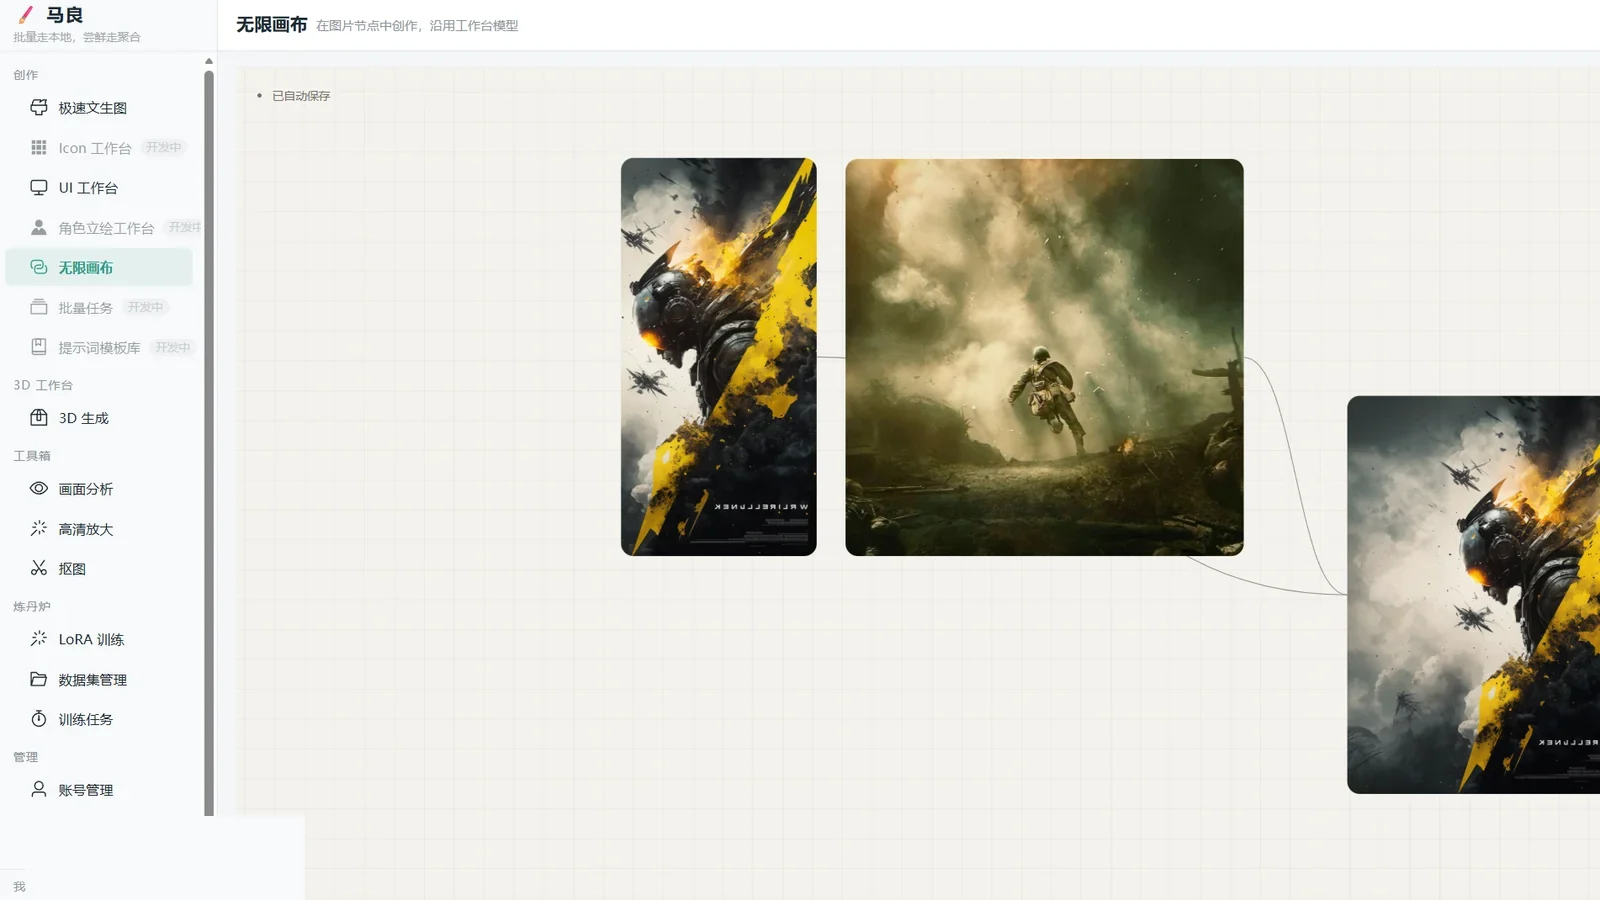
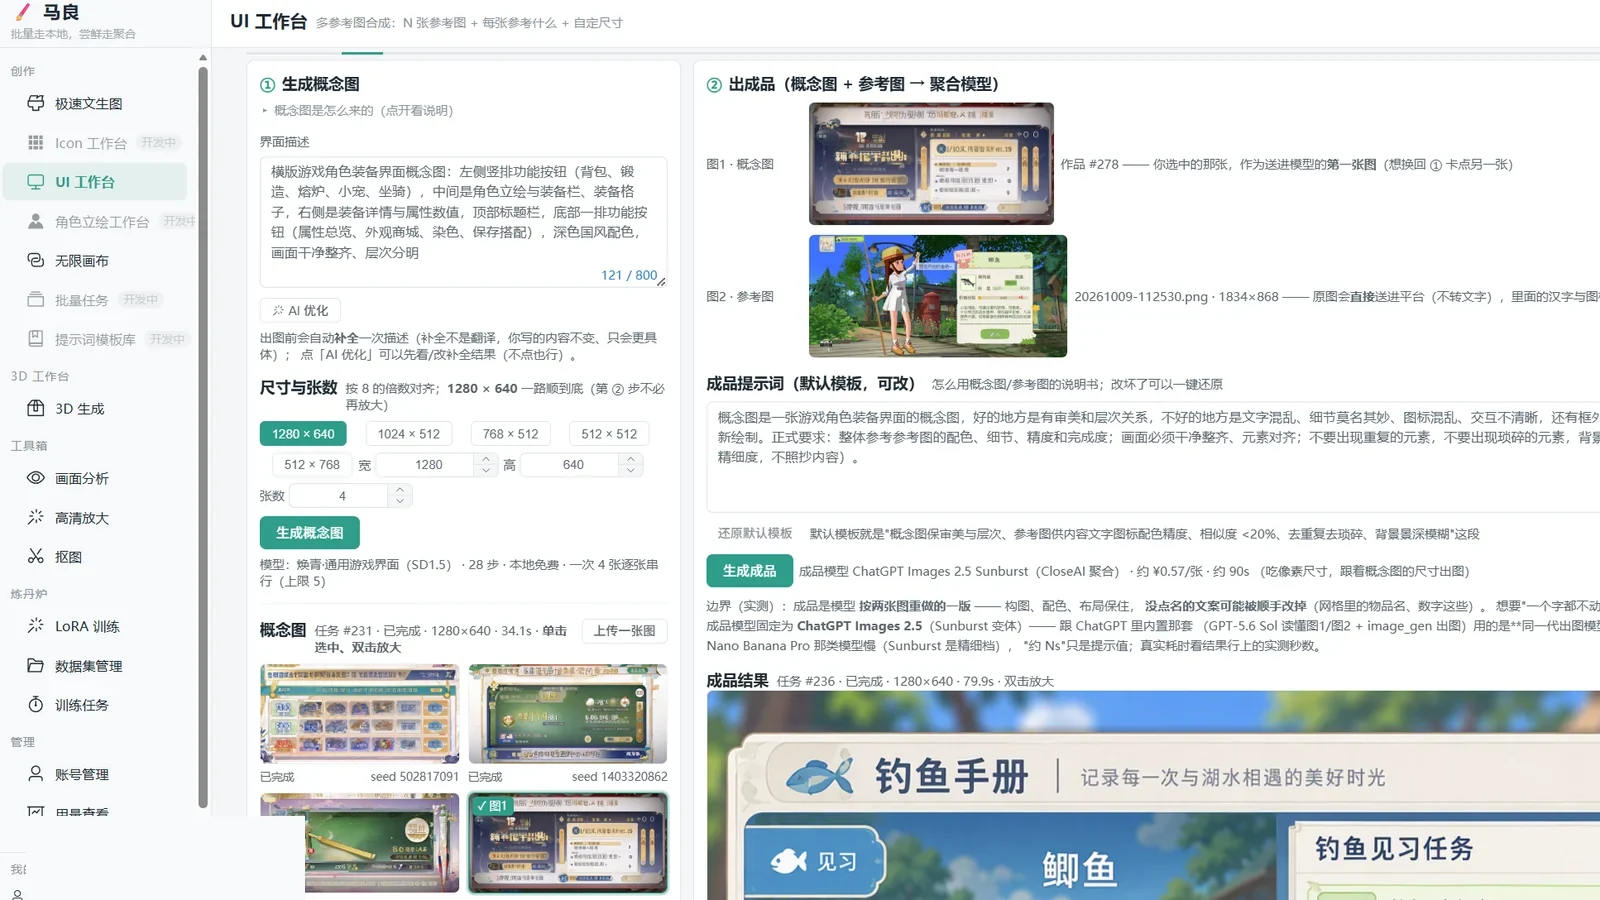
四、多参考图合成要点名。 UI 稿这类需求常常是「主体照参考图 2、气氛照参考图 1」, 所以最多支持 10 张参考图,每张分别写清参考什么;没写明的那张,模型只能自己猜。
五、参数随产物存。 每次出图的模型、步数、尺寸、提示词与产物一起落库,第二次能复现同一张。
结果
单张 1024² / 9 步约 16 秒(RTX 5070 Ti 16GB 本机实测);提示词优化 1.2 秒,优化到出图端到端 17.3 秒。 聚合通道已接入并真实调用通过(按张计费,页面显示成本预估,4K 档禁用)。 界面这一层另外跑了 186 项视觉自检:无头浏览器量真实计算样式,不是截图比对。
边界
这套东西的上限由提示词与模型决定,不由平台决定。平台负责的是「谁在用、用了多少、参数是什么、 产物在哪」;至于「出一张就能用」,它不负责 —— 那仍然要美术同学自己判断。
另外两件事要提前说清:这套现在就跑在内网单机上,多人的账号、配额、审计是能用的, 但没经过生产流量验证;按张计费的通道账单随用量走,平台只做成本预估与档位限制,不替客户控预算。