这条链路解决的是什么
单张 AI 出图早就不稀奇了,真正难的是让一张张图连成一部片子:角色在第 3 场和第 9 场得是同一个人, 同一场戏换个机位空间关系不能崩,分镜得按剧本走,参数还得能复现。 这个工作台把这几件事固定成流程,并按「小说 → 剧本 → 场景 → 角色和道具 → 拍摄」五步组织。
做法
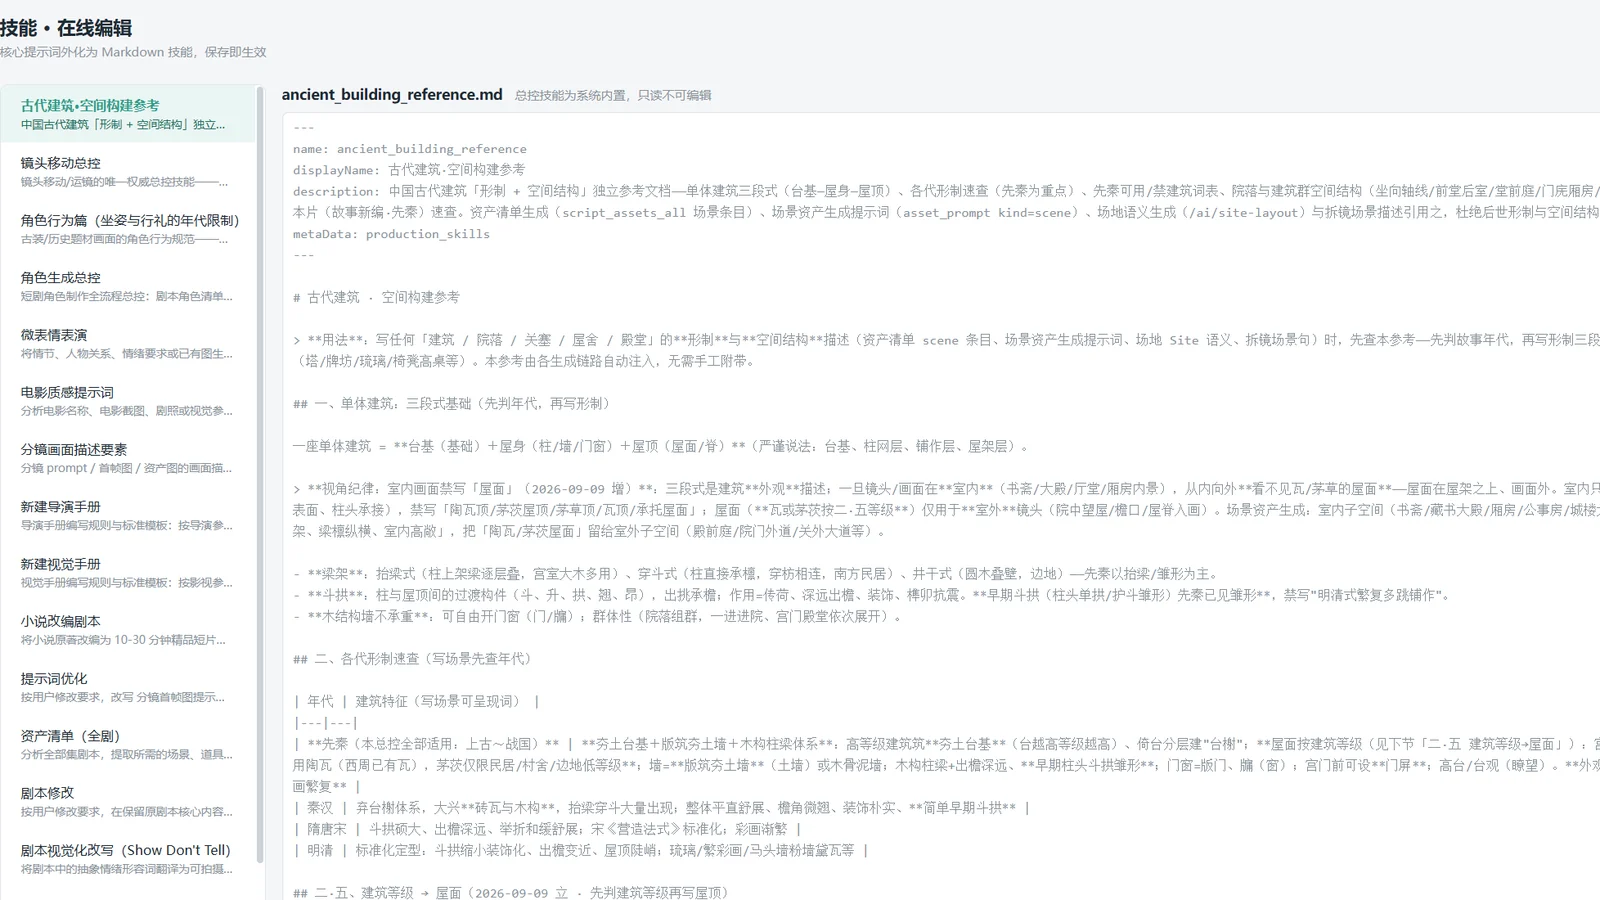
一、小说到剧本。 小说原文进工作台,先选视觉手册与导演手册(都是可编辑的 Markdown 技能), AI 改编成第一集剧本,之后按集管理。风格先定版 —— 风格不定版,后面所有镜头都会返工。
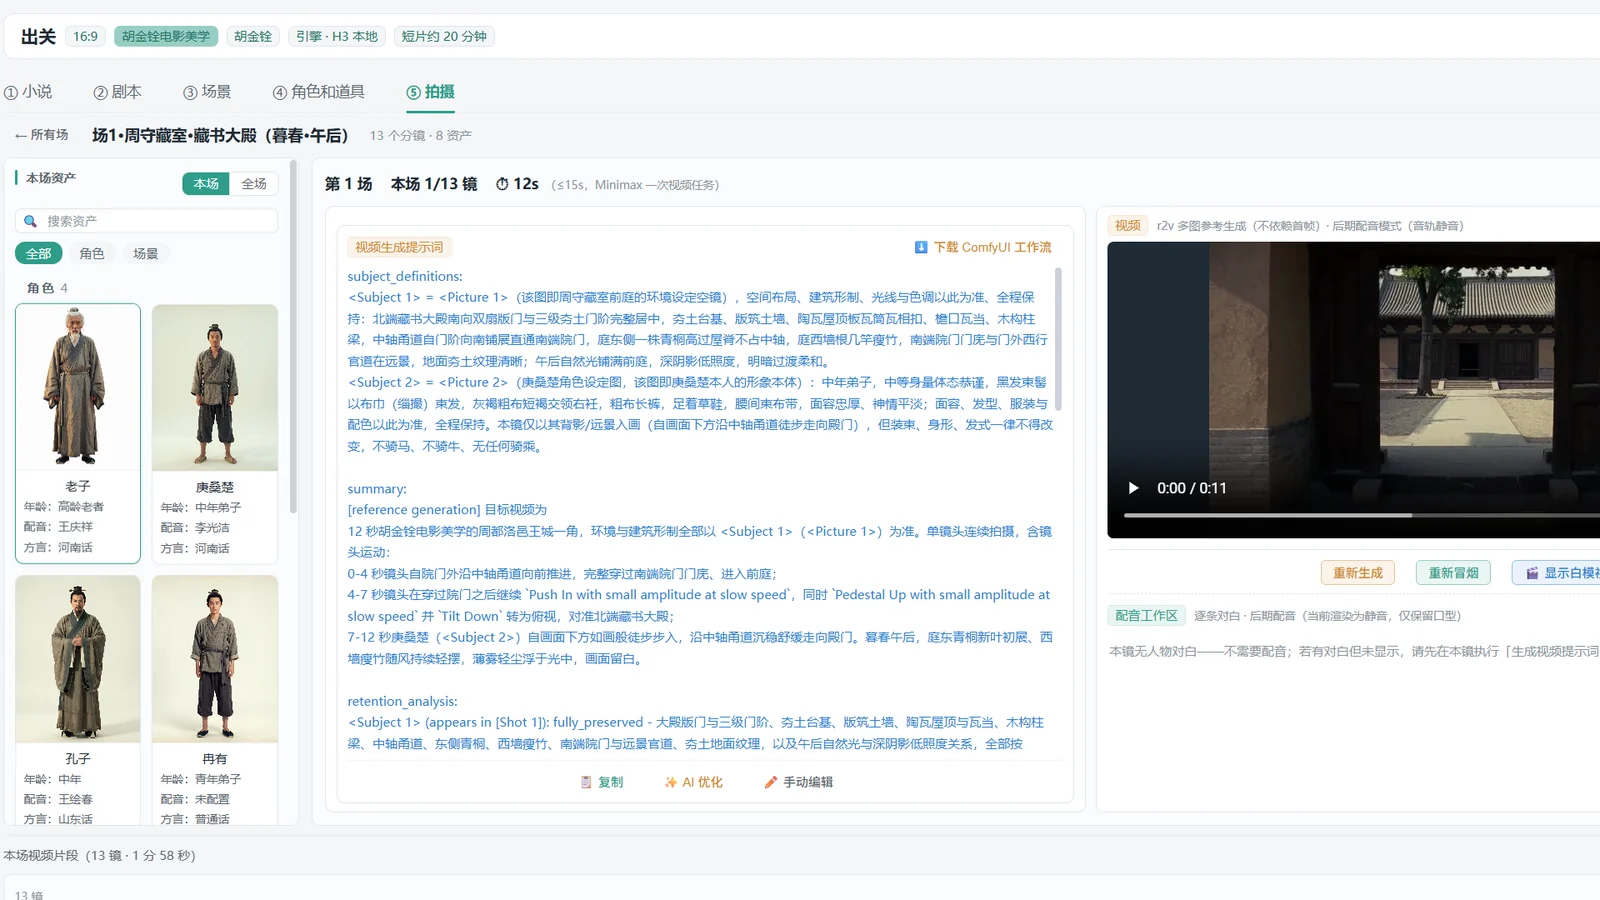
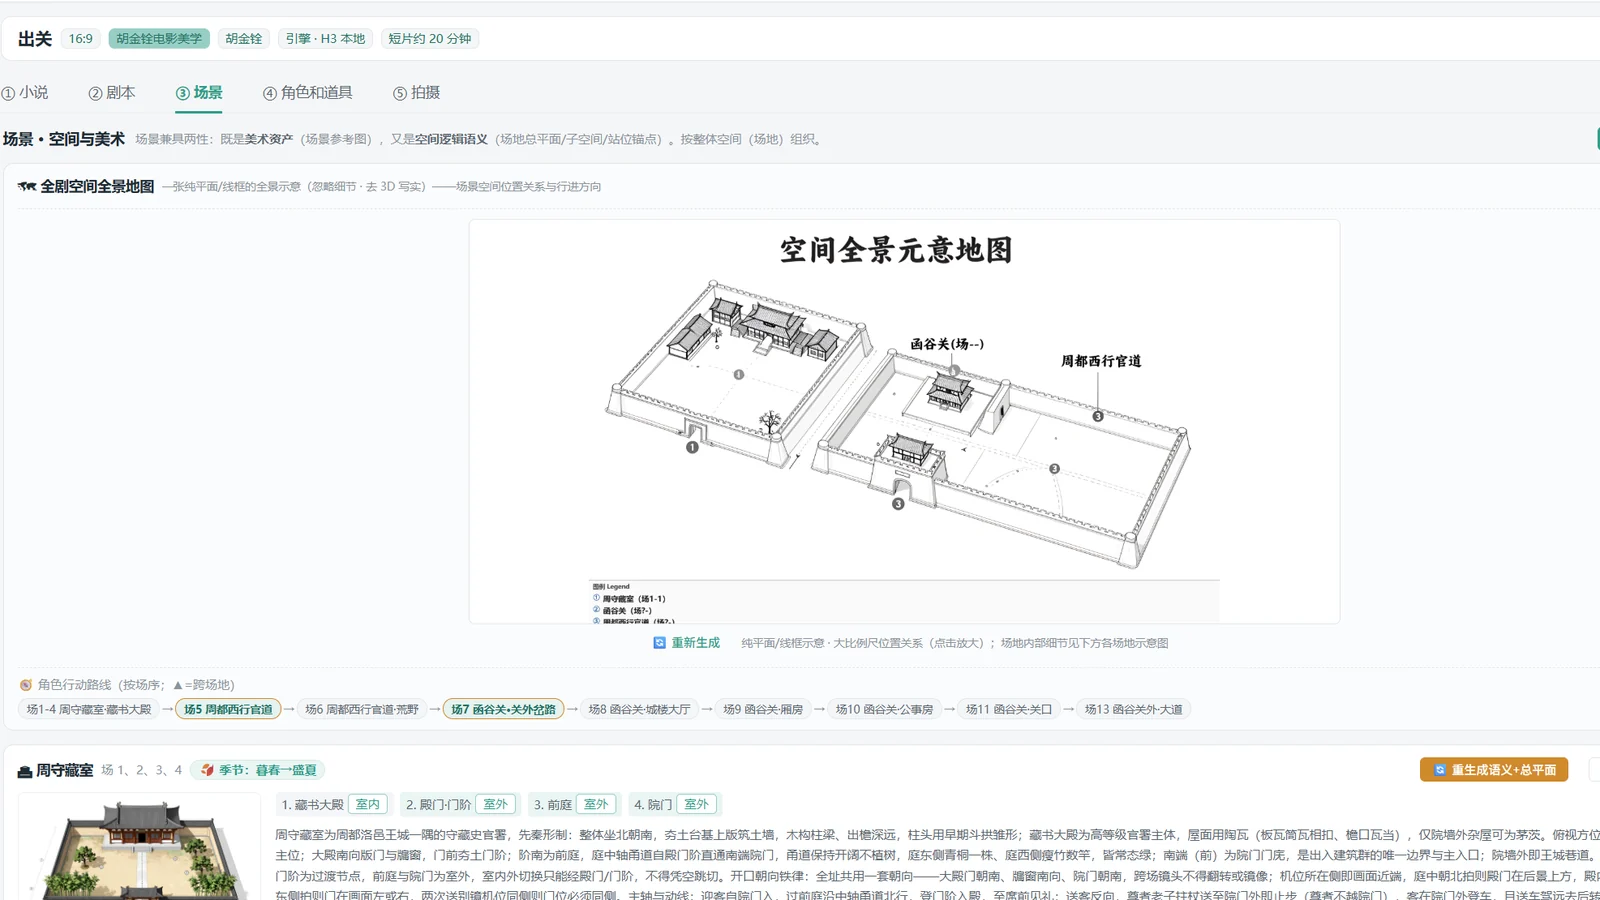
二、资产分析与场景管理。 剧本按场拆出角色、场景、道具三类资产,先生成设定图入库, 后续所有镜头都从资产引用,不靠文字描述「同一个人」。 场景资产额外挂一份场地与空间描述(哪进哪出、方位朝向、光源、季节),这是后面一致性的锚点。
三、场景一致性:先立 3D 白模,再上风格。 场景不是每镜现画:先按场地描述生成 3D 白模 (Blender 组装空间与机位),确认空间关系之后再让 AI 风格化 —— 同一场戏换机位时,空间关系不会跟着画风一起漂。
四、分场次镜头拍摄管理。 每场拆成若干分镜卡(序号、三段式提示词、竖屏分镜图、视频描述), 按场逐镜生成;批量生成自动跳过已完成的镜头,可以中断后续跑。
五、走位预演。 一镜里的角色站位与移动、相机运动交给模型排成结构化走位, 再用 Blender 渲成白模 mp4,作为视频生成的参考 —— 先把「人在哪、镜头怎么动」定下来,再谈画质。
六、本地与云端双引擎。 出图默认走本机 ComfyUI,出片默认走本机 H3; 需要更高画质或更快时整条切到云端通道(出图:百炼万相 / CloseAI;出片:火山方舟 Seedance, 云端的会把分镜参考图自动作为首帧)。 选了哪家就整条走哪家,不做静默降级 —— 画风一致性是硬约束,静默降级换来的是一批风格不一致的镜头。
结果
十一个环节全部跑通并留有实测数据(见上方数字表);产出侧累积了数百个生成资产与数十条冒烟视频, 每次生成用的模型、参数与提示词都随产物留档,可以回看、可以复现。
边界
只对可复现的流程与参数负责。内容是否符合平台要求、模型权重是否可商用,需要按项目单独确认。 剪辑与成片导出不在链路里(这一点在报价口径里也写明了):链路交到「分镜视频」, 转场、字幕、调色、混音这一步要另配后期。