脱敏声明 — 本项目是替服务对象做的内部系统,经沟通后以脱敏形式展示: 不出现客户名称、账号信息与可反查的内部细节。数字为该版本在验证环境下的实测结果。
问题
这家机构的招生、答疑、学员维护,全都发生在聊天窗口里。三年攒下来,教务老师与学生的 QQ 对话有 731 个会话、110,655 条消息;接待咨询的微信上还躺着 2,958 个联系人。 数据是有的,但没人翻得动 —— 想回答的问题都很具体,却一个都答不了:
- 这周谁咨询过?哪些人聊得很深却始终没报名?
- 没报名的人到底卡在哪:价格、时间,还是怕学不会?
- 这个学员是什么背景,值不值得优先回访?
报名表只覆盖「已经报名的人」。咨询了没报名的,一个都不在里面 —— 而既有脚本正是以报名表为权威的,名单外的人被主动丢掉。 另一边,同一个人在报名表、群名片、聊天里是三种写法,对不上号就只能人工核。
答疑(老师反复回答同一批专业问题)是这批重复劳动里最显眼的一件,但它只占全部需求的 1/8。
做法:先分线,再清洗
三种对话混在一起就没法处理,所以第一步是把它分成三条线,各自有入口、产物和能看的人:
| 线 | 谁的对话 | 出来什么 | 谁能看 |
|---|---|---|---|
| A · 教务线 | 教务老师与已报名学生 | 学员画像(一人一行)+ 学员档案库 | 仅教务 / 管理员(含姓名、手机号) |
| B · 答疑线 | 答疑老师与学生 | 脱敏后的问答库 | 学生可查 |
| C · 咨询线 | 教务在专用工作机上接待的咨询者 | 咨询台账 + 周报 | 仅教务 / 管理员 |
混线的后果不是「数据难看」,而是把含手机号的学员档案喂给学生端 —— 所以两个库在配置层面就是分开的。
六步清洗(以教务线为例):收编 → 格式归一 → 归属 → 脱敏 → 抽取 → 出表。
其中归属决定成败:聊天里是群名片(期数 + 姓名 + 指导老师),花名册里是姓名加 QQ 号,
只按姓名匹配时首轮只命中 17 条;改成优先用 QQ 号匹配、群名片姓名兜底之后,命中 203 / 240。
咨询线那一步是反着来的。 教务侧没有任何成形的咨询表,名单只能从聊天里反推。 后来发现一个更简单的事实:那台 iPhone 是专用工作机,只用来处理咨询报名 —— 于是它的微信通讯录就是那份「不存在」的咨询表:2,958 个联系人,备注常写成「姓名-课程-手机号」。 用通讯录减去报名表里已有的人,剩下的就是咨询未报名者。 这条路比只导聊天记录更全:只聊过三句、甚至一句没聊就加了好友的人,在通讯录里也在。
模型只做抽取,不做决定。 脱敏之后再送模型,按人分块(滑窗 + 重叠)抽事实, 冲突单独落表、不自动合并;送模型前把昵称换成「学员 / 老师」角色标签, 否则它会把群名片上的班级和老师当成对话里说过的话。群名片不算证据 —— 那是名单对齐该负责的事。
结果
教务线:731 个会话、110,655 条消息 → 240 人花名册 → 归属命中 203 → 抽出事实 2,020 条、冲突 3 条 → 一人一行的画像表(5 页签、58 列)+ 240 张学员卡进检索层。 画像字段规范为 6 组 58 项。
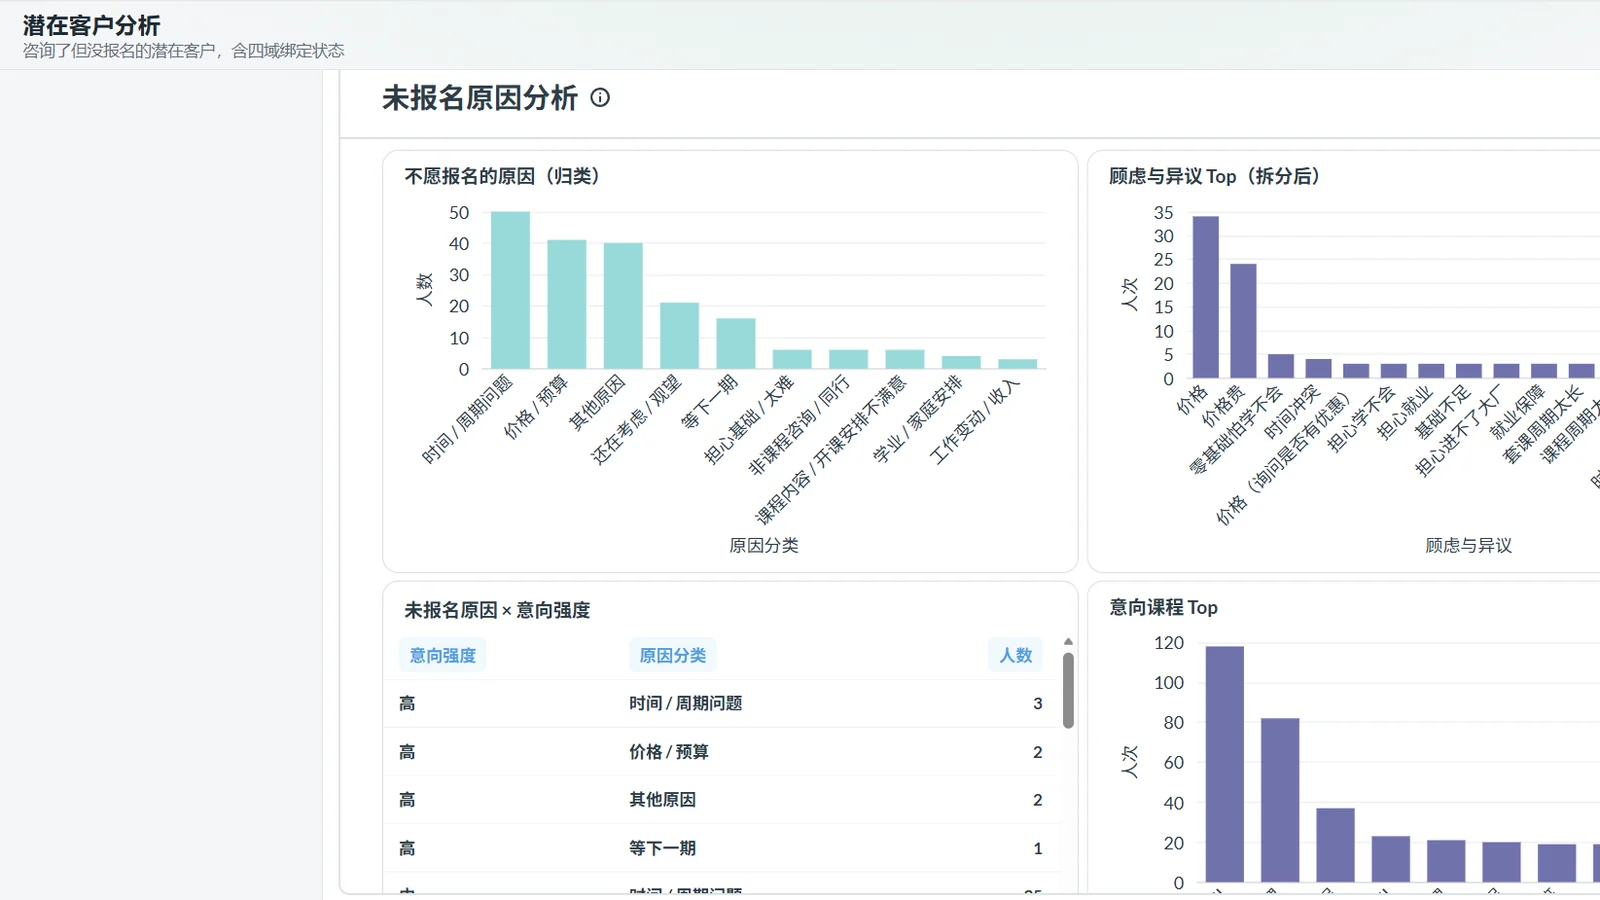
咨询线:微信通讯录 2,958 人 → 减去已报名者 → 咨询台账 2,714 人, 带搜索(昵称 / 备注 / 微信号 / 手机号)、筛选(渠道 / 意向强度 / 状态 / 对话深度 / 最近联系)、 证据摘录(点开看原话)、手机号默认打码 + 看真值留痕,每周更新一次。 看板:未报名原因归类、顾虑与异议 Top、意向课程 Top、获客渠道与班级构成。
一条已经能用的结论:按对话深度分档之后,聊得越深报名率越高 —— 这个排序直接变成跟进优先级(先给谁打电话),不再靠感觉。
答疑线(顺带跑通的一条):22 条问答对 / 67 条相似问,命中 77.8%、零误命中、响应 2–3 秒。
边界
覆盖率低是真实状态,不是没做完。 2,714 人里只有 6.0% 留了手机号、28.4% 标了来源渠道、 4.2% 主动说了未报名原因;1,245 人只有通讯录关系、一条消息都没有。 所以界面顶部必须标出「这是标注覆盖率」,而不是拿它当全员结论。
抽出来的「事实」是证据,不是判决。 冲突单独列出、人工裁决;机器不得覆盖教务填的值 —— 界面上也不允许造成「在这改了就算数」的错觉。
两个库绝不混用。 含手机号的画像与台账只给教务 / 管理员,学生端只查脱敏后的问答库。 个人微信没有合规的自动化路径,咨询线的取数走专用工作机的导出,不是读库、更不是机器人。
三块缺口如实写在界面上:自媒体的内容数据(小红书 / B 站)现在没有、 课程平台的学习数据没打通、「流失」的定义还没定。
答疑那 77.8% 是样例语料上的:它证明的是链路通、阈值策略有效, 不是「上线后学生的问题能答上 77.8%」。真实语料进来之前,那个数字无从谈起。