这条产线解决的是什么
UGC 带货短视频有两个真难点:结构(前 3 秒钩子放什么、几秒开始演示、什么时候上 CTA)和 文字(包装上的品牌名、成分、容量不能被 AI 改掉)。前者靠模板复刻,后者靠掩码重绘。
做法
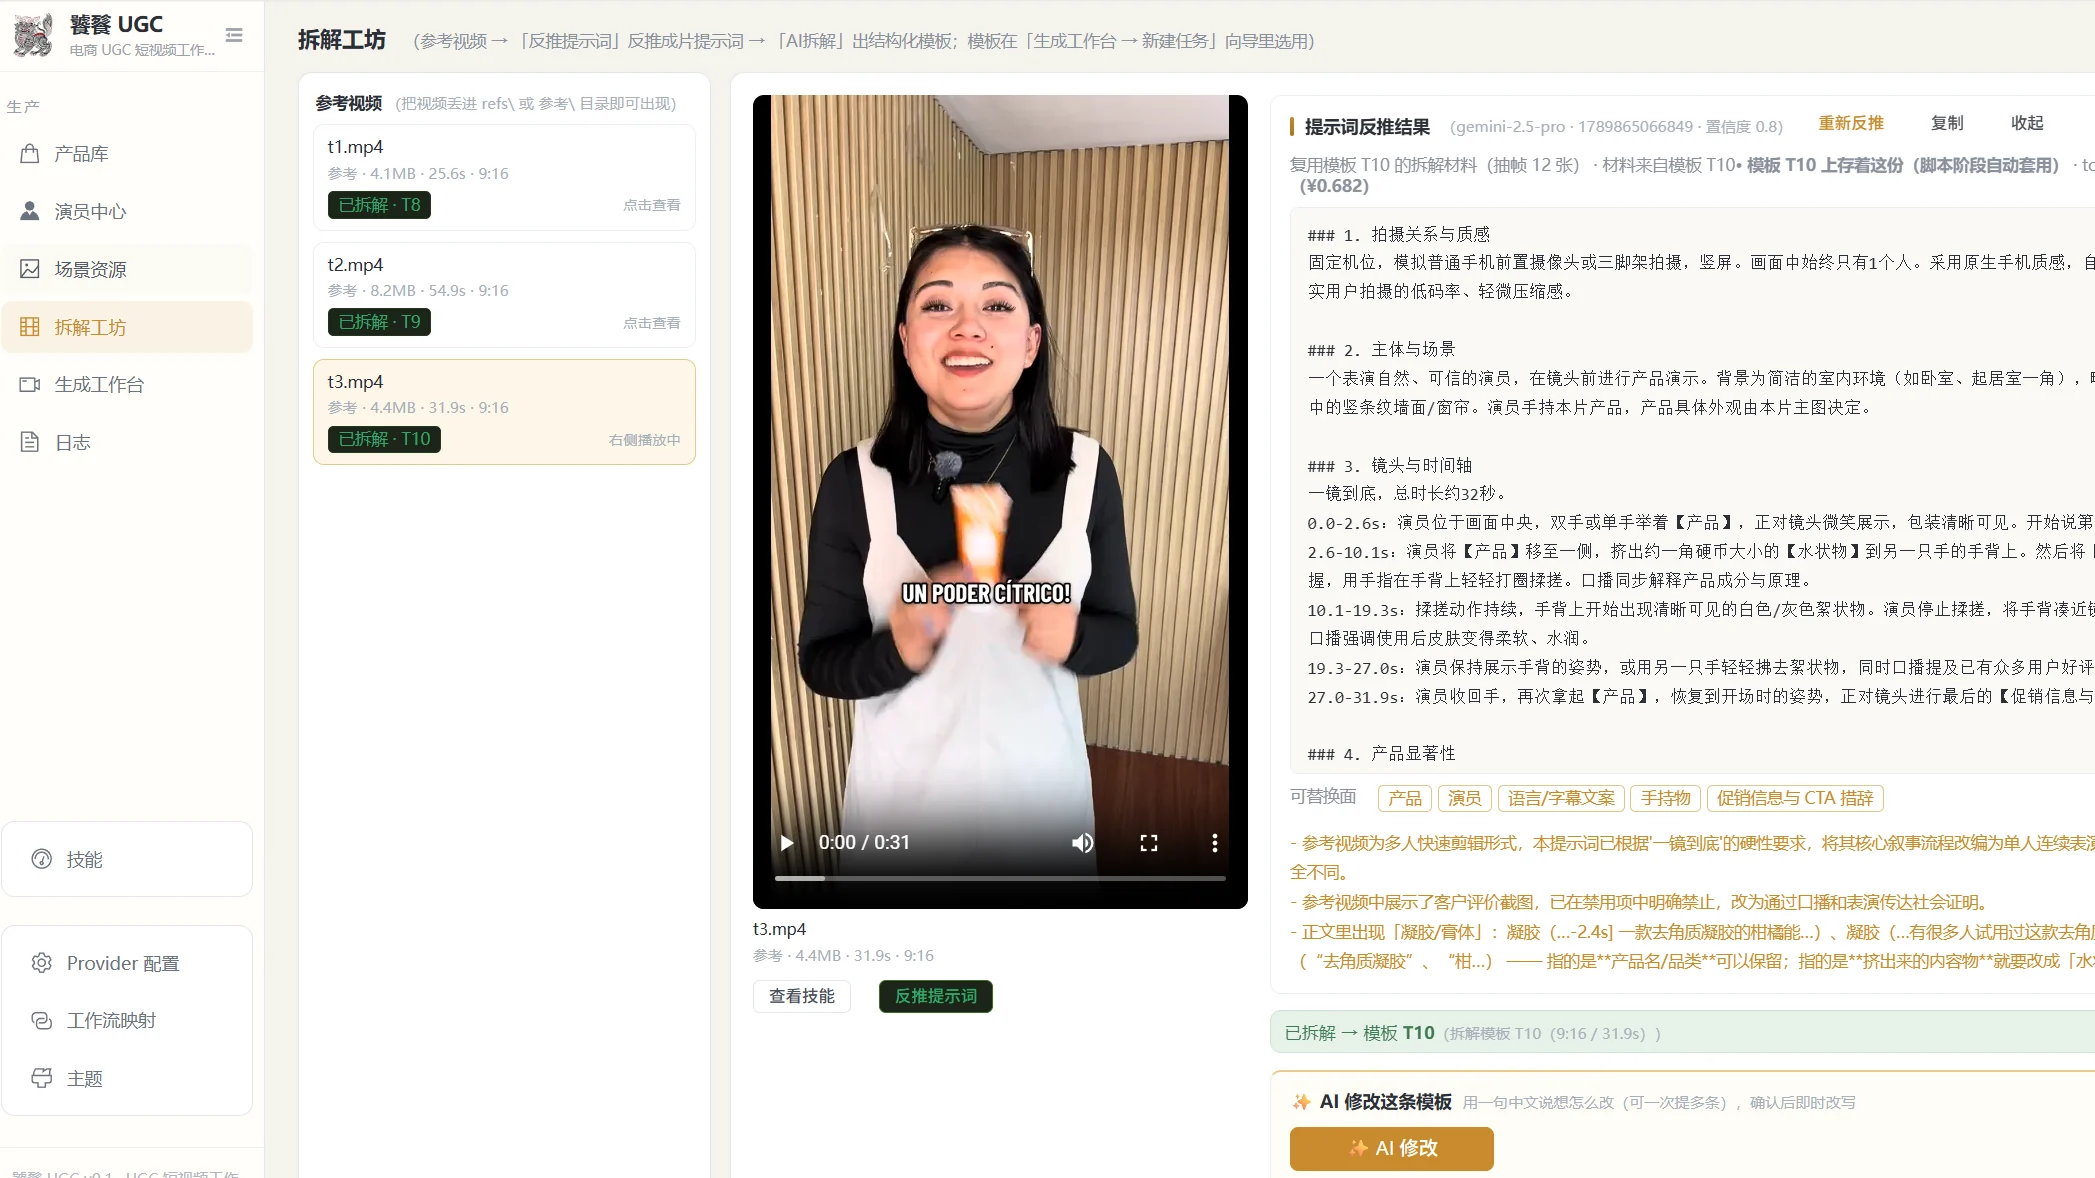
一、模板分析复刻。 参考片丢进 refs/ 目录就能一键拆解:场景切点检测 →
按镜头中点抽帧(≤8 帧)→ 先判有没有口播(纯音乐的片子不跑转写,否则音乐段会生出幻觉台词)→
转写 + 本机视觉模型批量描述 → 归纳成结构化模板,最后过一遍机器自检
(时间轴是否首尾相接、段数、槽位是否抽象)。
模板只输出 JSON、不臆测:台词里的产品名、成分、价格一律替换成槽位; 一镜到底的片子如实标单镜,多镜必须给切点 —— 不许为了好看谎报。拿到的模板可以直接套到新产品上复刻同款结构。
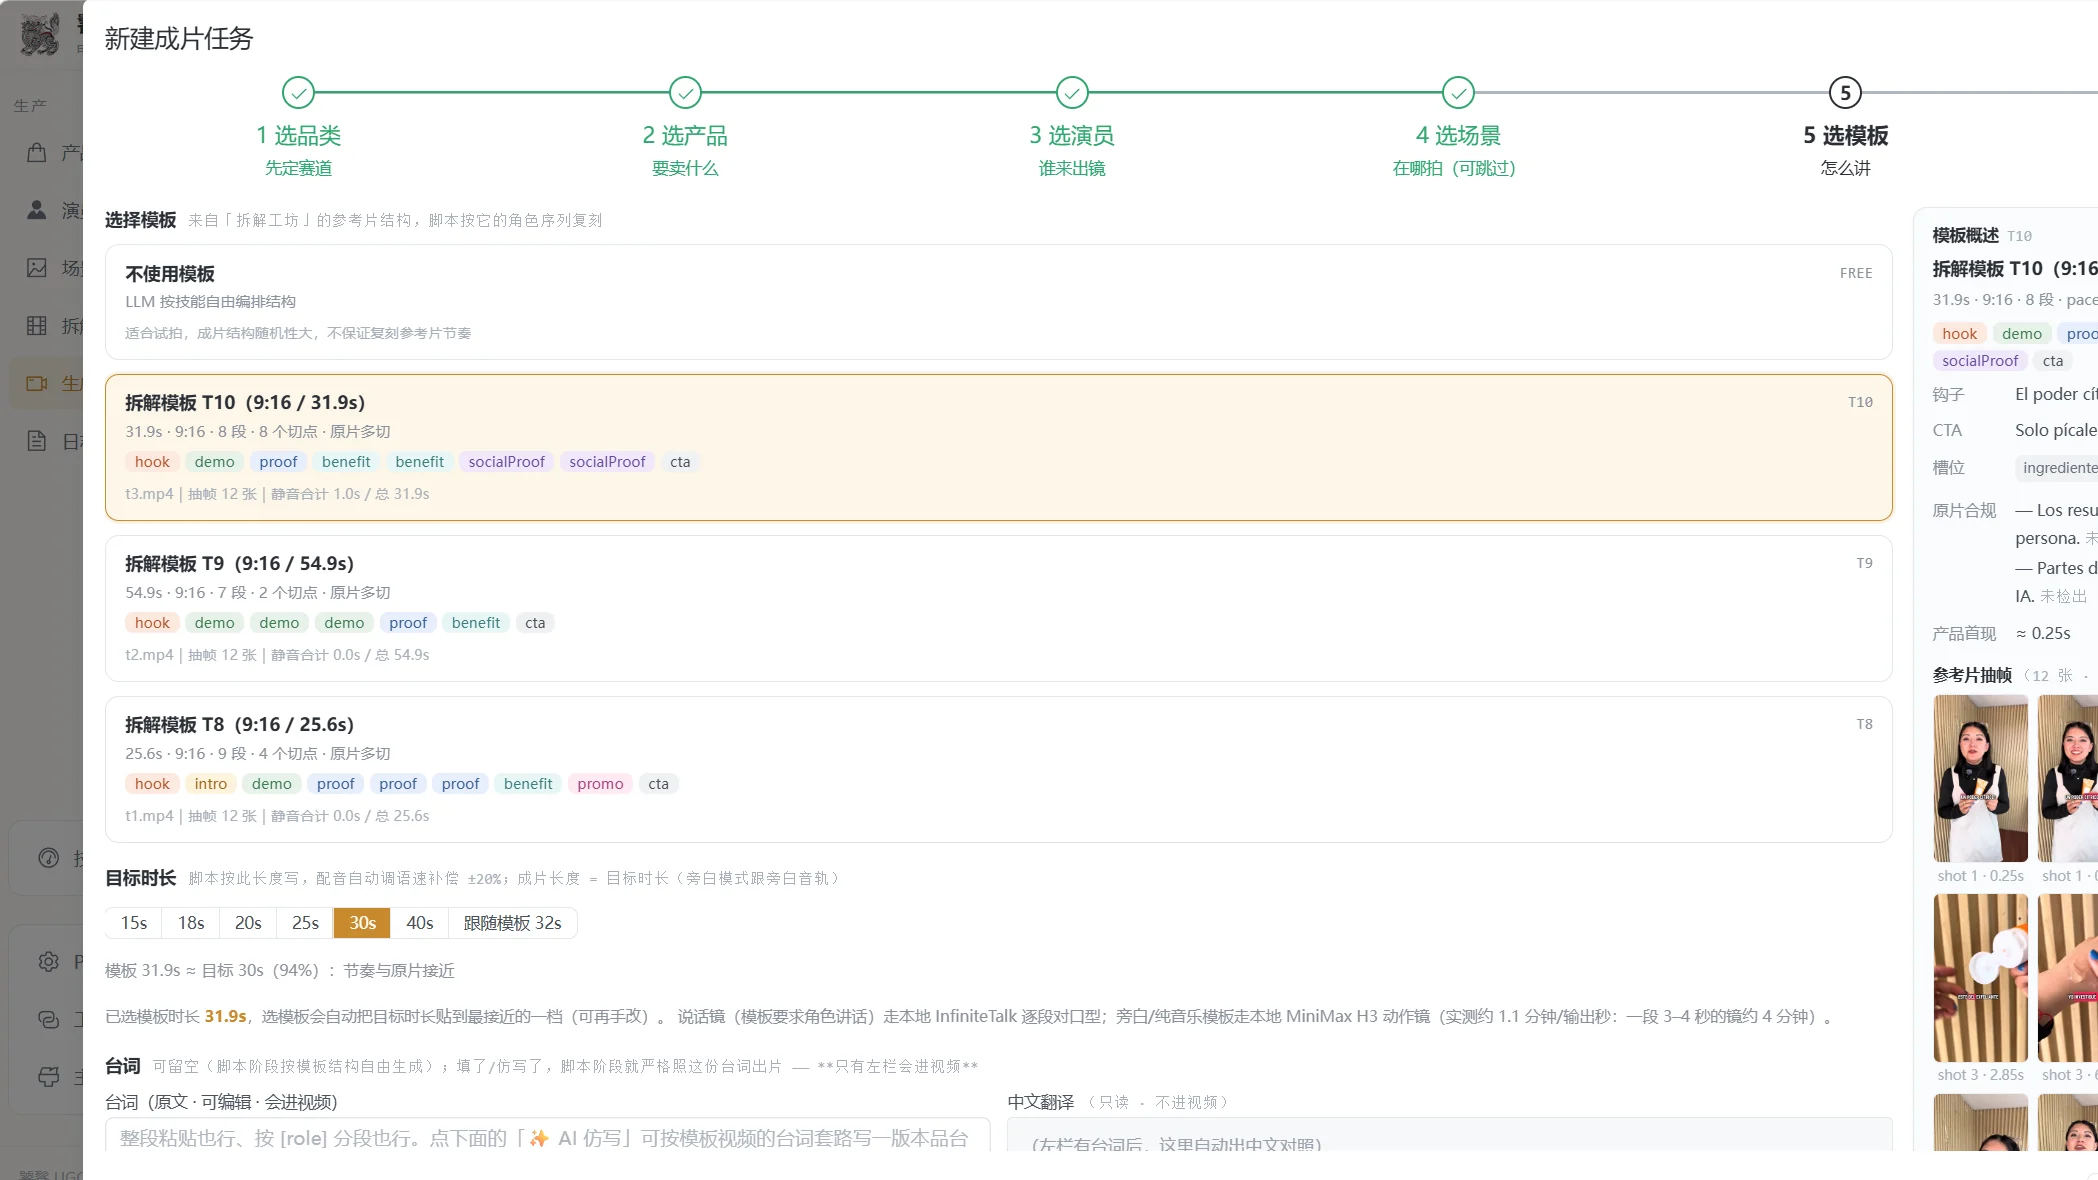
二、双引擎。 一条任务走本机(开源)还是走云端(闭源),是向导里的显式一步: 闭源侧列出可选模型、档位与这条片的粗估花费;两条链路可用的模式不完全一样 (云端目前只覆盖口播成片,旁白与纯音乐走本机)。 选哪条就整条走哪条,不静默降级 —— 换来的是画风与口型的可预期。
三、三种模式,按模板声明走。 口播(逐段对口型)、旁白(静音动作镜 + 整篇旁白)、 纯音乐(静音动作镜 + 花字)。后两种不需要角色讲话,所以不跑口型模型: 既绕开「口型不匹配」,也避免口播模型在没有产品的镜头上凭空演出一支产品 —— 而且视频阶段零 GPU。
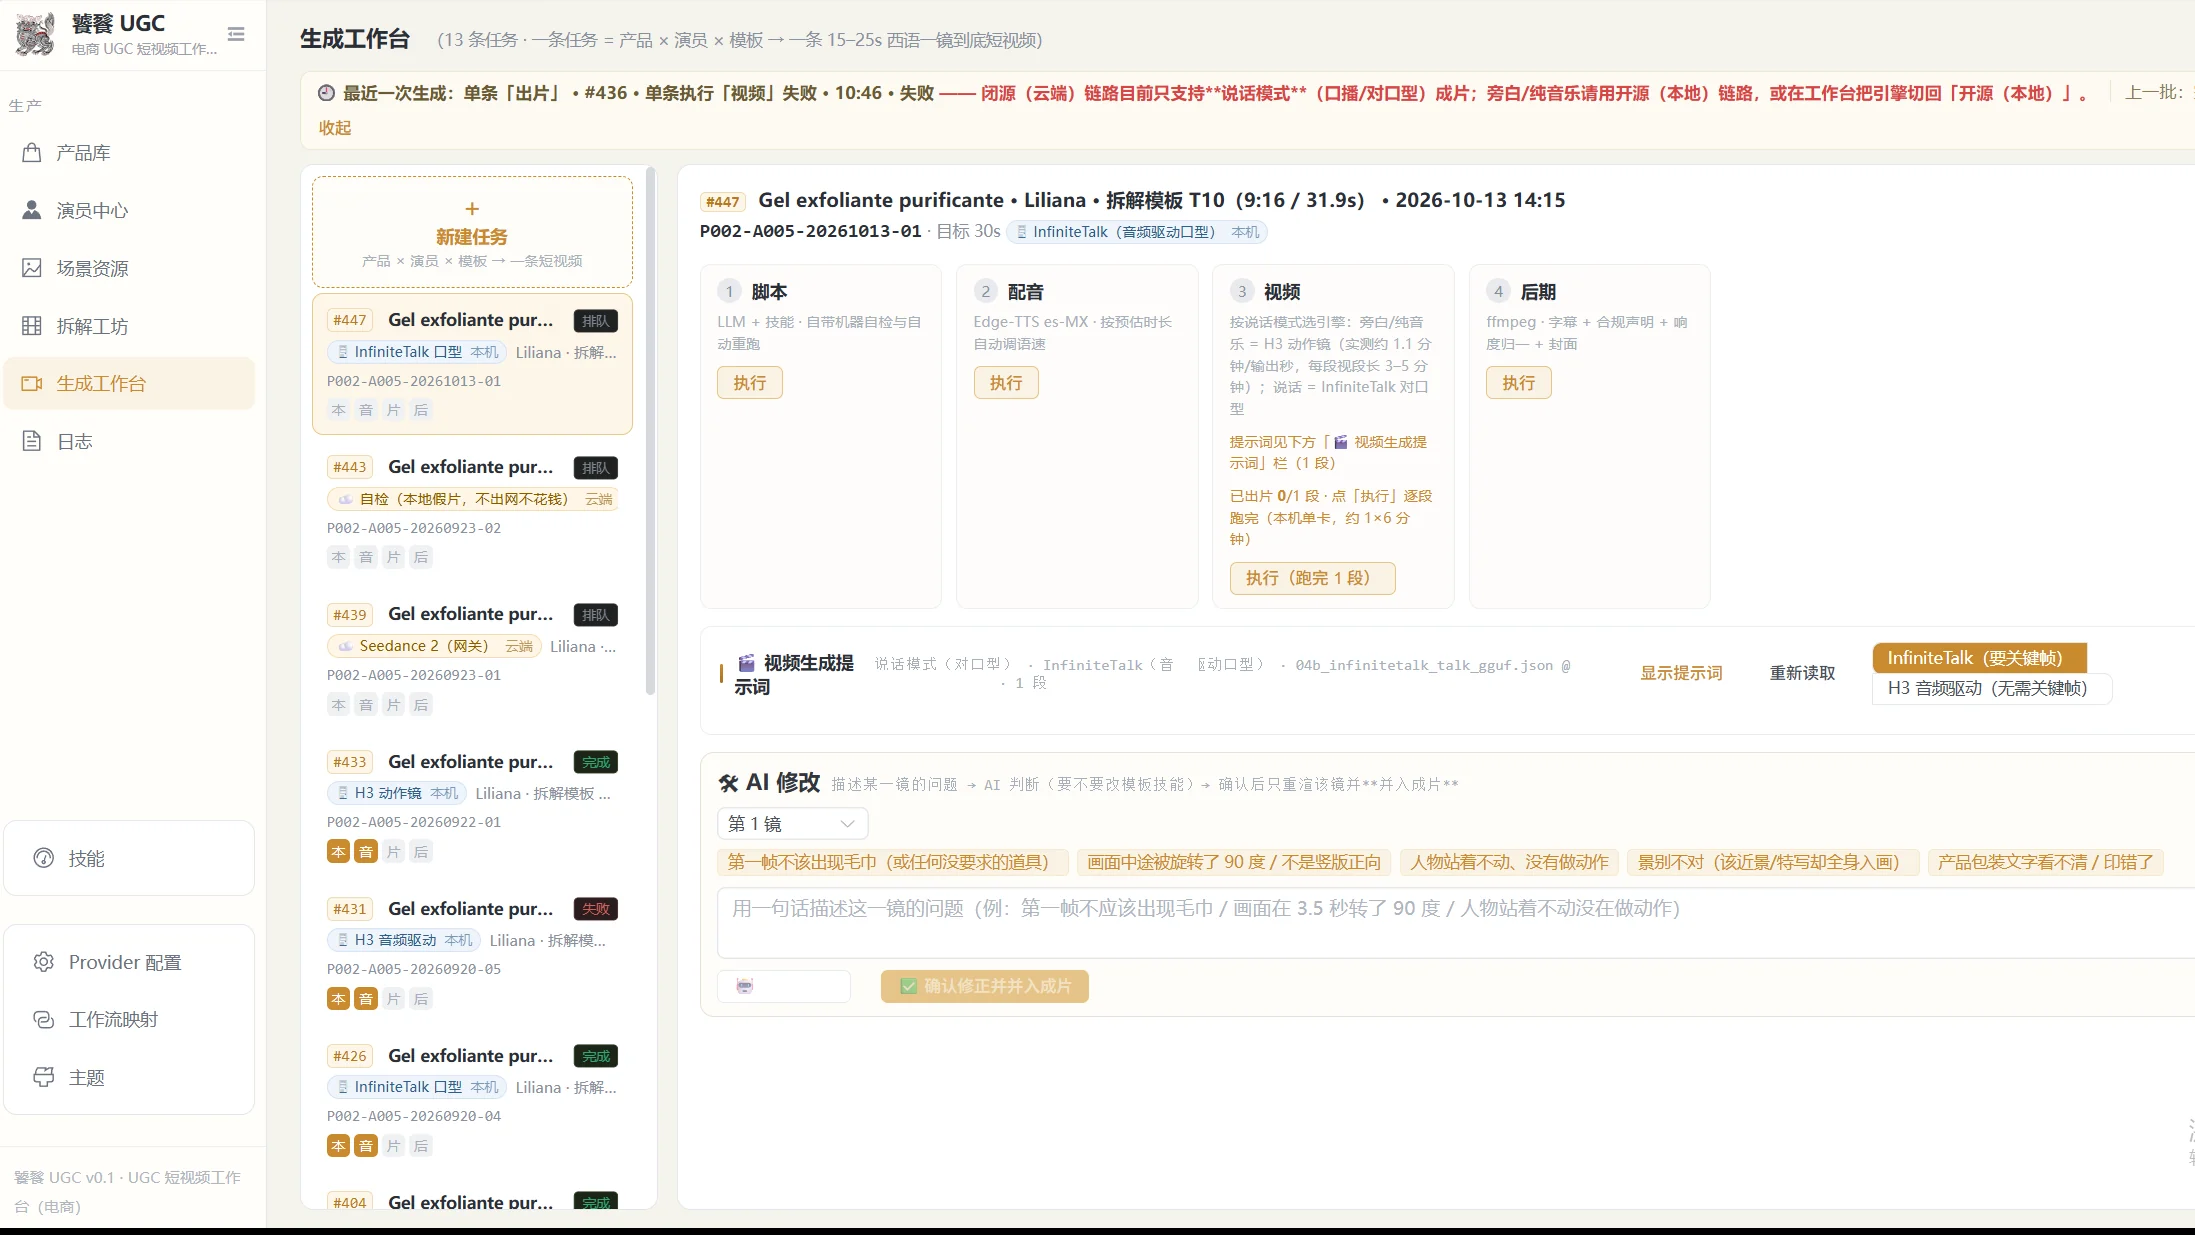
四、批量生产。 一条任务拆成脚本、配音、视频、后期四段逐段执行,每段可单独重跑; 批量出片自动跳过已完成的部分,中断了能接着跑;同一产品的多个版本(换演员、换话术) 共用一个实例窗口,摊薄权重加载开销。
五、文字保真用掩码重绘。 先算出可重绘区域,把包装文字与商标排除在外,只在允许的区域生成: 未掩码区像素差 0.02。旧路线的教训是整图重绘 —— 5 条样本 0 条过、3 条 0 条过, 还把「50g」编造成「30ml」。
六、合规内置。 AI 披露、免责声明、水印在生成阶段就烧进画面,不靠后期补。
结果
一条参考片 35 秒拆完,模板可直接套用;口播档一条 15 秒成片约 27 分钟 GPU(本机); 旁白与纯音乐档因为视频阶段零 GPU,出片时间从 30–90 分钟压到几分钟。 单条边际成本是本机档的电费(≈ ¥0.5–1)加大模型调用(¥0.01–0.05),不含人力与折旧。
边界
产能跟着显卡走:单卡日产 15–25 条是硬件约束而不是软限制,要更多产能就是加机器,没有魔法。 而且最重的那档视频模型本地放不下(最小权重约 34GB vs 本机 16GB 显存), 超过 15 秒的成片要么用云端实例、要么换卡。
云端档的账要按用量算:按量计费与包月实例差近一倍,日产稳定时包月更划算 —— 这条是资源决策,不是技术问题,所以在方案里单独列出来。
复刻的是结构,不是素材:模板给的是段落角色、时长占比、切点与话术范式, 原片的镜头、音乐、真人素材不会进成片。素材版权与肖像授权需要确认来源合法,这一条不由系统兜底。
只交付产物与产线,不替客户承担平台过审的结果责任:合规声明与 AI 披露会烧进画面, 但最终标准以平台规则为准。